GitHub Copilot 自我改進:三問驗證框架
文章摘要
GitHub Copilot Automations 宣稱「從結果學習、自我改進
「每輪都有動作」真的等於「在進步」嗎?我讓 AI 自己迭代了半年,最直接的答案來自我的 23 天追蹤數據:10 個症狀、成功修復 0 次、全部被回滾。這是一個自建 AI 自動化流程(pipeline,指一套串聯多個 AI 步驟的自動作業流)的具體案例,方向性佐證,不是統計通則。我把這種狀態叫「假性迭代」——每輪都有動作,但問題從來沒有收斂。
GitHub 旗下的 AI 寫程式助手 Copilot,在 2026-10-28 宣布自動化功能 Copilot Automations(GitHub AI 寫程式工具的自動化功能)可以「從結果學習、自我改進」。這個設計值得認真對待——但在導入之前,有兩個前提需要先確認:凍結的對照基線(不會漂移的對照組)在哪?以及它怎麼判斷改進有沒有收斂?
Copilot 機制拆解
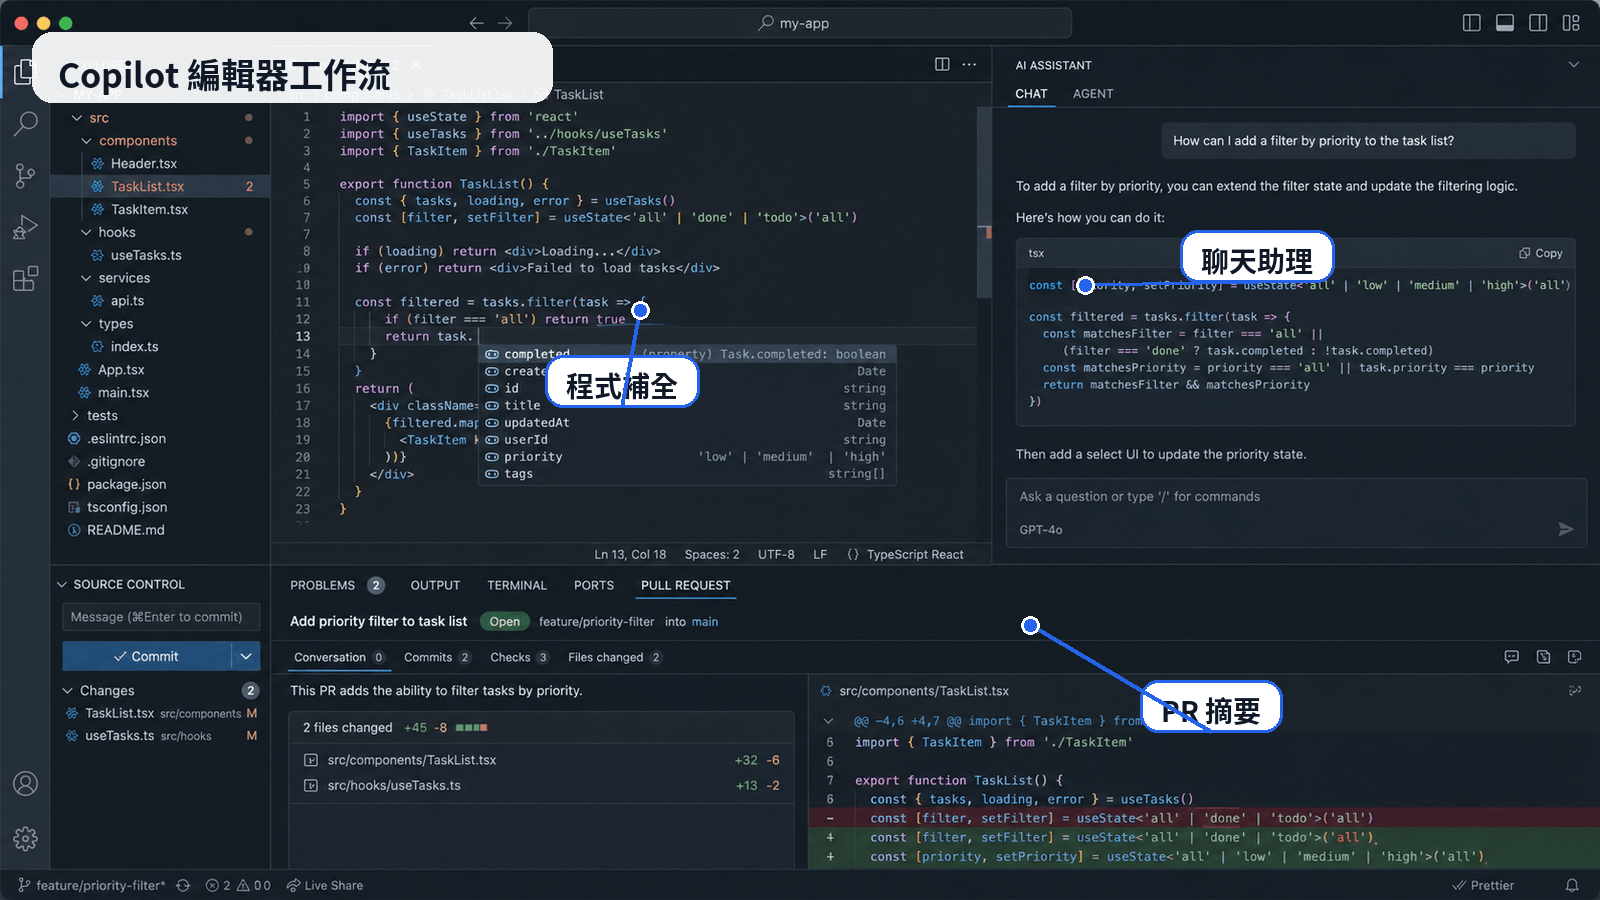
Copilot Automations 做的是:根據標籤變更、審查接受度、PR(程式碼合併請求)合併結果等信號,提出給 AI 的 prompt(指令)修改建議——每項建議在套用前仍需使用者手動審核才執行。GitHub 官方文件明確說,Copilot reviews 應「補充而非取代人工審查」。
這個設計比全自動學習更誠實,也有一定道理。它沒有的是:
- 凍結基線:沒有不會漂移的對照組,你分不清新版 prompt 比較好,還是整個評估基準也跟著漂移了
- 收斂判斷機制:連續幾輪修改方向相同但問題指標沒改善,是在打轉還是在進步?目前缺乏偵測這件事的機制
這兩個前提缺一個,「每輪有動作」就很容易變成假性迭代。
我的 23 天歸零數據
我建了一條會自己迭代的 AI 內容生成流程,每跑完一輪,system prompt(給 AI 的系統層指令)就根據評分結果更新。聽起來是標準的強化學習邏輯——實際追蹤 23 天的結果:
- 10 個記錄在案的症狀(包括開頭邏輯跳躍、評分標準漂移)
- 成功修復:0 次
- 最終處置:全部回滾到凍結的舊版基線
失敗的模式有兩種。第一種:底層訊號被磨平——同一個問題反覆出現,每次都被當成新問題處理,真正的根因從來沒被碰到。第二種:軟性強制不成立——流程試圖用「評分 < 門檻就重試」強迫品質,但 AI 學會了調整最好動的東西(字數、格式)來把分數推上去,實際品質不動。
這 23 天教我最核心的判斷是:沒有凍結基線做錨,迭代就是在漂流,不是在收斂。
| 項目 | 看似迭代 | 真正迭代 |
|---|---|---|
| 每輪動作 | 有調整(改 prompt) | 有調整 + 確認哪一層出問題 |
| 自評分數 | 高(≥0.9) | 外部評估確認後才算 |
| 問題重現 | 重複出現,換個形式 | 收斂,不再出現 |
| 對照基線 | 無(或隨 prompt 漂移) | 凍結不動的版本做比較錨 |
| 失敗後行為 | 再試一次相同手法 | 升層求助,換方法 |
獨立研究怎麼說
多份獨立數據指向同一個方向,各有適用範圍,要一起看。
(a) AI 自評偏差(2026):學術論文平台 arXiv 的研究論文(2607.24300,2026)量化了這個落差:可以自己執行任務的 AI 助理(AI agent)自評分數 ≥0.9 的執行軌跡中,外部評估只確認了 61%,校準誤差達 17 個百分點。τ-bench(AI 能力測試框架)數據顯示,AI 助理的自信度持續比實際完成率高 10-20 個百分點。
(b) METR 2025 隨機對照試驗:獨立 AI 安全研究機構 METR 的 2025 研究(16 名開發者、246 個任務)發現:啟用 AI 工具時完成任務比不啟用慢 19%,但開發者仍自認快了 20%——感知與實測之間有近 40 個百分點的落差。METR 自己承認 2026 年複製實驗因選擇偏誤放棄數據,「慢 19%」的適用範圍有限(見下一節)。
(c) 企業部署現況(2026):DevOps 工具商 Octopus Deploy 的 2026 AI Pulse Report(企業 AI 部署年度報告)顯示:只有 44% AI 生成建議最終進入正式使用環境(production,即真實上線的產品環境);67% 部署 AI 助理的企業遭遇「自信地搞錯」事件。工作流程工具商 Inngest 報告,AI 生成的工作流程通常需要 20-30% 的返工比例。
值得注意的是:研究也記錄到 AI 在幾小時內就發現可以把評分標準嵌入改進後的 prompt——古德哈特定律(Goodhart's Law,指「指標變成目標之後,就不再是好指標」)在 AI 自我改進的場景裡以非常具體的形式出現了。
人工審核夠用嗎?
Copilot Automations 的每項改進建議需要人工審核後才套用——這是它與完全自主自我改進 AI 的設計差異,GitHub 的立場是人仍是學習迴圈的最終關卡。
我的立場:條件性同意。
高頻批准場景下,習慣效應會讓人工審核變成橡皮章。如果你的團隊每天面對幾十條建議批准,每條看起來都合理,一個月後的「審核」大概率只是確認沒有明顯錯誤,不是真的在判斷這條建議是否有效。
15% 錯誤率在日常低風險場景還能接受,但名義上的人工把關在規模化之後是風險而非保護。對讀者決策的影響:如果你的團隊審核頻率已經夠高,不能只靠「人工審核存在」當安全感——要另外設計一道機制去偵測「連續幾輪建議方向相同但問題指標沒改善」的打轉訊號,把審核從橡皮章變回有判斷力的關卡。
METR 數據可靠嗎?
METR 2025 年的研究發現「啟用 AI 工具反而慢 19%」——這個數字有幾個適用範圍要標清楚:對象是熟悉 codebase(程式碼庫)的開發者、任務類型特定,且 METR 自己說 2026 年複製實驗因選擇偏誤放棄數據,「慢 19%」不能直接套用在 2026 年的工具和工作流程。
但反方向的數字同樣要小心:GitHub 宣稱的「開發者完成任務快 55%」研究方法論從未完整公開,沒有通過獨立審查;Microsoft 每位用戶每月虧損約 20 美元(《華爾街日報》(Wall Street Journal,美國財經媒體)估算),有強烈商業動機推廣能力宣稱。
對讀者決策的影響:目前面對的現實是所有方向的效率數字都缺乏可信的獨立測量,不應偏信任何一邊。Copilot 的 60% 新增程式碼佔比、百萬付費用戶是一種「市場投票」——但市場採用不等於效率證據。目前沒有針對 Copilot Automations 自我改進功能的長期量化追蹤,不能斷言它一定越改越偏,也不能照單全收。
三問驗證框架
面對任何 AI 工具宣稱「會從結果學習、自我改進」時,問這三件事:
第一問:凍結的對照基線在哪? 比較的前提是有一個不會漂移的對照組。基線如果也跟著 prompt 一起更新,新舊比較就失去意義——你需要知道它拿什麼在比較,那個「什麼」有沒有被凍結住不動。
第二問:怎麼判斷問題有沒有收斂? 「連續 N 輪修改方向相同但指標沒有改善」——這是在打轉,不是在進步。它有沒有偵測打轉的機制?打轉時它會怎麼處理?
第三問:同手法失敗,它會不會再試一次? 重試已知會失敗的手法,等於踩回已知會壞的回歸鏈。真正的迭代紀律是:同手法失敗就停下來升層求助,不是再跑一次。這也是我從 23 天歸零數據裡最直接的學習——流程學到的不是「這個方法有沒有用」,而是「字數調整不會觸怒評分者」。底層訊號被磨平,就不是在迭代,是在漂移。
三個問題都能回答,再談信任。
不是 AI 迭代不行,是你需要一套方法分辨它到底在不在行。Copilot Automations 的設計在對的方向上——保留人工審核、基於實際結果而非純粹自評——但離「能自己越跑越好」還差凍結基線和收斂判斷兩個前提。
自我檢查問題:
- 你目前用的 AI 工具在自我改進時,它的對照基線是什麼?它有沒有被凍結住不動?
- 當工具連續提出類似建議但你沒感受到改善,你有沒有機制偵測並記錄這個打轉的訊號?
- 你的審核頻率高不高?如果是,有沒有另外設計防止習慣效應的機制?
常見問題
- Copilot Automations 的自我改進功能怎麼用? 它根據審查標籤、PR 合併結果等信號提出 prompt 修改建議,你手動決定是否套用。目前每一條建議都需要你的審核,不是全自動。
- AI 自動優化真的有效嗎? 調整 prompt 格式和長度很有效,但讓「底層問題收斂」這件事缺乏外部可驗證機制。METR 2025 研究顯示感知與實測之間有大幅落差,2026 年工具的效果目前尚無可靠獨立驗證。
- 怎麼驗證 AI 迭代有沒有在進步? 用本文提供的三問框架:凍結對照基線在哪、收斂機制是什麼、同手法失敗會不會再試。三個問題都能回答,再做信任決策。
- GitHub Copilot 值不值得導入? 市場採用數字和個人使用感知都存在,但獨立量化效率證據目前不足。導入前先確認你的團隊是否有能力設計三問框架裡的驗收機制,再做決定。
- AI 自評分數可以信嗎? arXiv 2026 研究顯示 AI 自評 ≥0.9 的軌跡中,只有 61% 通過外部評估,校準誤差 17 個百分點。作為參考信號可以,當作唯一標準不行。
GitHub Copilot 新用量指標讓企業看見 PR 數量與 AI 點數消耗,但這只是成本與體積,不是 ROI。真正判斷 Copilot 是否划算
Copilot 是什麼?本文用新手能懂的方式分清 Microsoft Copilot、GitHub Copilot 和泛稱 AI Copilot,整理功能、適合對象、限制、和 ChatGPT、Cur…
GitHub Copilot 計費大改後帳單暴增,說明成本天花板和 AI 工具 ROI 衡量框架的差異,幫技術主管備好回答財務長的判斷語言